W analizie z 30 września 2026 r. Artificial Analysis podaje dla Gemini 4 Argon (high) wynik 53 w Intelligence Index, równy GPT-6 Astra (max). Koszt zadania wynosi 1,99 USD w promocji i 3,98 USD przy standardowym cenniku. Autorzy zaznaczają, że dostęp obejmuje wybranych użytkowników, a termin zakończenia promocji pozostaje nieznany. Źródło: Artificial Analysis.
Dla zespołu wybierającego model do agenta to powód, żeby uwzględnić Argon w testach, gdy uzyska dostęp. Decyzję o wdrożeniu uzależnilibyśmy od kosztu wykonania konkretnej pracy: z poprawkami, ponowieniami i kontrolą wyniku. Poniżej przedstawiamy nasz sposób oceny. Nie prowadziliśmy własnych pomiarów tego modelu.
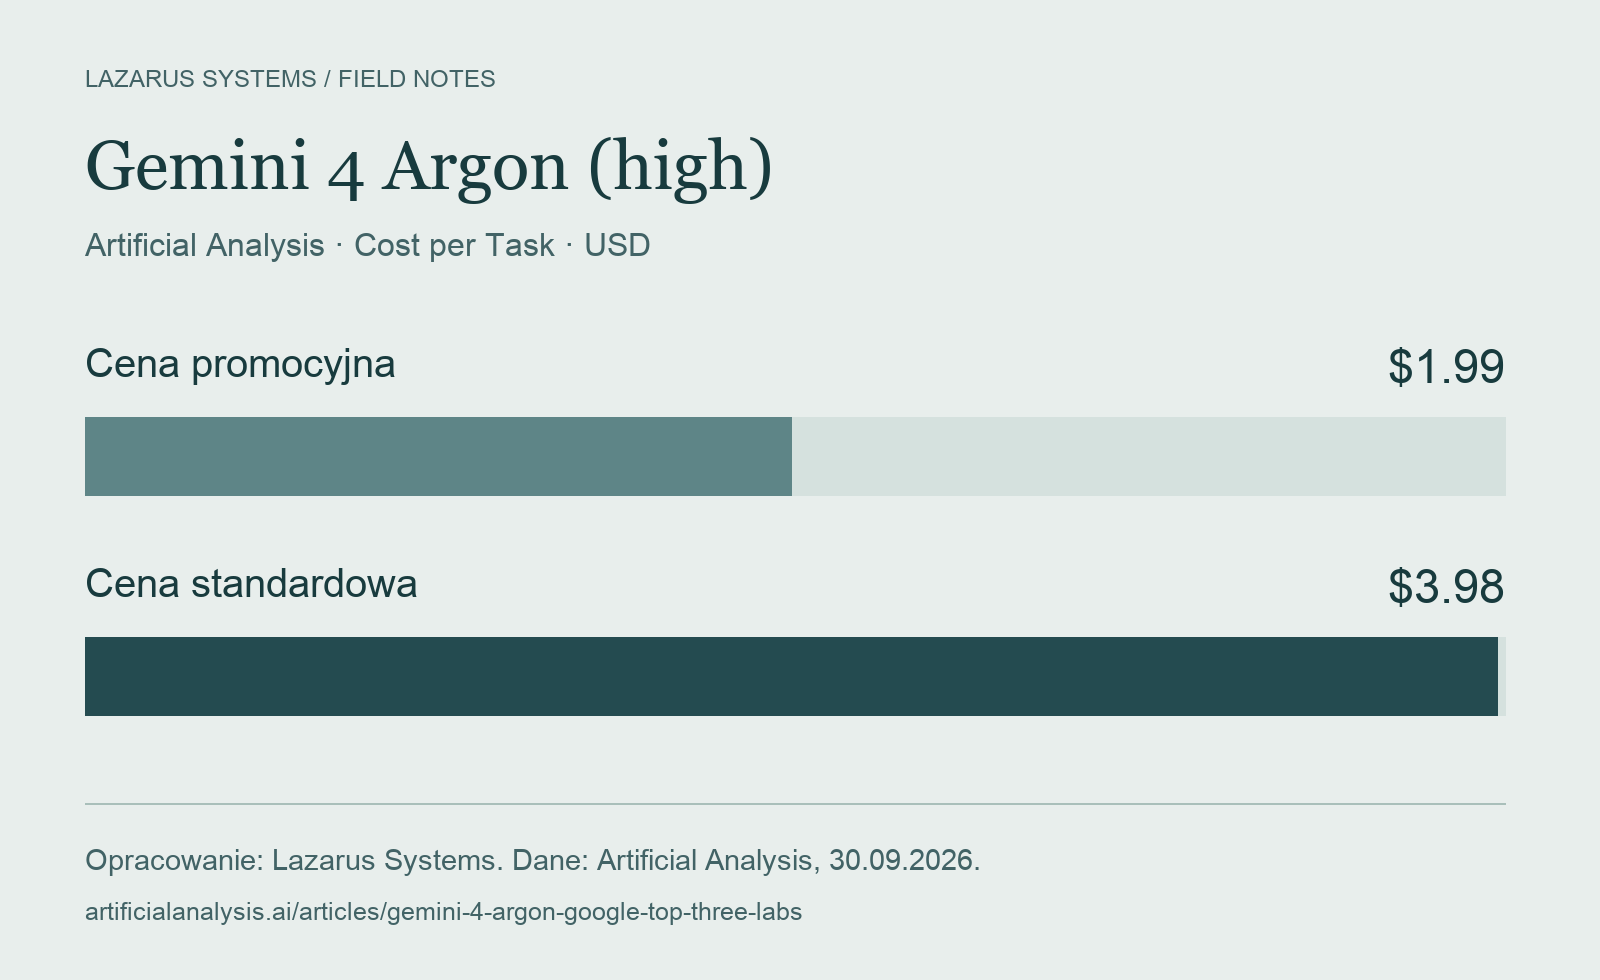
Co właściwie kosztuje 1,99 USD
W metodologii Artificial Analysis Cost per Task oznacza ważony średni koszt zadania z zestawu Intelligence Index. Obliczenie uwzględnia zużycie tokenów wejściowych, buforowanych i wyjściowych oraz ich ceny. Skład zestawu i wagi benchmarków wpływają na wynik.
Nie można więc przyjąć tej kwoty jako ceny obsługi faktury czy analizy umowy. Nasz agent może potrzebować kilku wywołań modelu, zapytania do wyszukiwarki i ponowienia kroku po błędzie. Część odpowiedzi będzie wymagała sprawdzenia przez człowieka. Każdy z tych elementów powinien mieć osobną pozycję w kalkulacji.
W budżecie pilotażu przyjęlibyśmy cenę standardową. Promocja może obniżyć rachunek w trakcie eksperymentu; projekt powinien się opłacać także po jej zakończeniu. Jeśli oszczędność pojawia się wyłącznie przy rabacie, warto zapisać to wprost w decyzji o uruchomieniu.
Próba na rzeczywistych dokumentach
Załóżmy, że agent ma porównywać zamówienia z fakturami i wskazywać rozbieżności. Przygotowalibyśmy zamknięty zestaw dokumentów z opisanymi oczekiwaniami. Powinny znaleźć się w nim skany słabej jakości, brakujące strony, różne waluty i dokumenty, których nie da się jednoznacznie przypisać do zamówienia.
Przed testem trzeba ustalić, co uznajemy za poprawny wynik. Samo wygenerowanie odpowiedzi nie wystarcza. Agent powinien wskazać właściwe dokumenty, prawidłowo odczytać kwoty oraz oznaczyć sprawy wymagające decyzji operatora. Ocena odpowiedzi po obejrzeniu nazwy modelu utrudnia uczciwe porównanie; w miarę możliwości ukrylibyśmy tę nazwę przed osobą oceniającą.
Każdy model otrzymałby ten sam zestaw narzędzi i te same ograniczenia. Zapisalibyśmy czas całego wykonania, koszt wszystkich wywołań, liczbę ponowień oraz czas potrzebny na sprawdzenie odpowiedzi. Osobno policzylibyśmy błędne akceptacje: przypadki, w których agent uznał niezgodny dokument za poprawny.
Warunki zmiany modelu
Próg akceptacji powinien wynikać z procesu firmy. Przy wstępnym porządkowaniu dokumentów można dopuścić inny poziom błędu niż przy zatwierdzaniu płatności. Porównanie modeli ma sens dopiero po ustaleniu, które działania agent wykonuje samodzielnie, a które przekazuje do zatwierdzenia.
W protokole testu zapisalibyśmy dokładną wersję modelu, ustawienia rozumowania, cennik i datę pomiaru. Do decyzji dołączylibyśmy przykłady błędów oraz koszt poprawnie zakończonej sprawy. Z takim zapisem można później sprawdzić, czy nowa wersja modelu faktycznie poprawia wyniki.
Dane benchmarkowe pochodzą z publikacji Artificial Analysis wskazanej powyżej. Propozycja testu i wnioski wdrożeniowe są komentarzem Lazarus Systems.